Cómo funcionan los rastreadores de IA: GPTBot, ClaudeBot, PerplexityBot y tus decisiones de robots.txt
GPTBot, ClaudeBot y PerplexityBot no son un solo bot cada uno. Esto es lo que hace cada rastreador de IA y cómo controlarlos en robots.txt.
OpenAI, Anthropic y Perplexity operan más de un rastreador cada una. Algunos entrenan un modelo. Otros alimentan una función de búsqueda en vivo. Otros solo obtienen una página porque una persona le pidió a un asistente que la revisara. Tú controlas cada uno por separado en robots.txt, mediante su propio nombre de user agent. Desde septiembre de 2022, robots.txt es un estándar formal de internet, RFC 9309, pero sigue siendo una convención voluntaria: un rastreador se mantiene fuera solo si su operador decide respetar el archivo.
Qué son los rastreadores de IA y por qué no son rastreadores de buscadores
Los rastreadores de búsqueda tradicionales como Googlebot hacen un solo trabajo: encontrar páginas e indexarlas para los resultados de búsqueda. Los rastreadores de IA dividen ese trabajo en tres categorías distintas, y cada categoría tiene su propio nombre de bot.
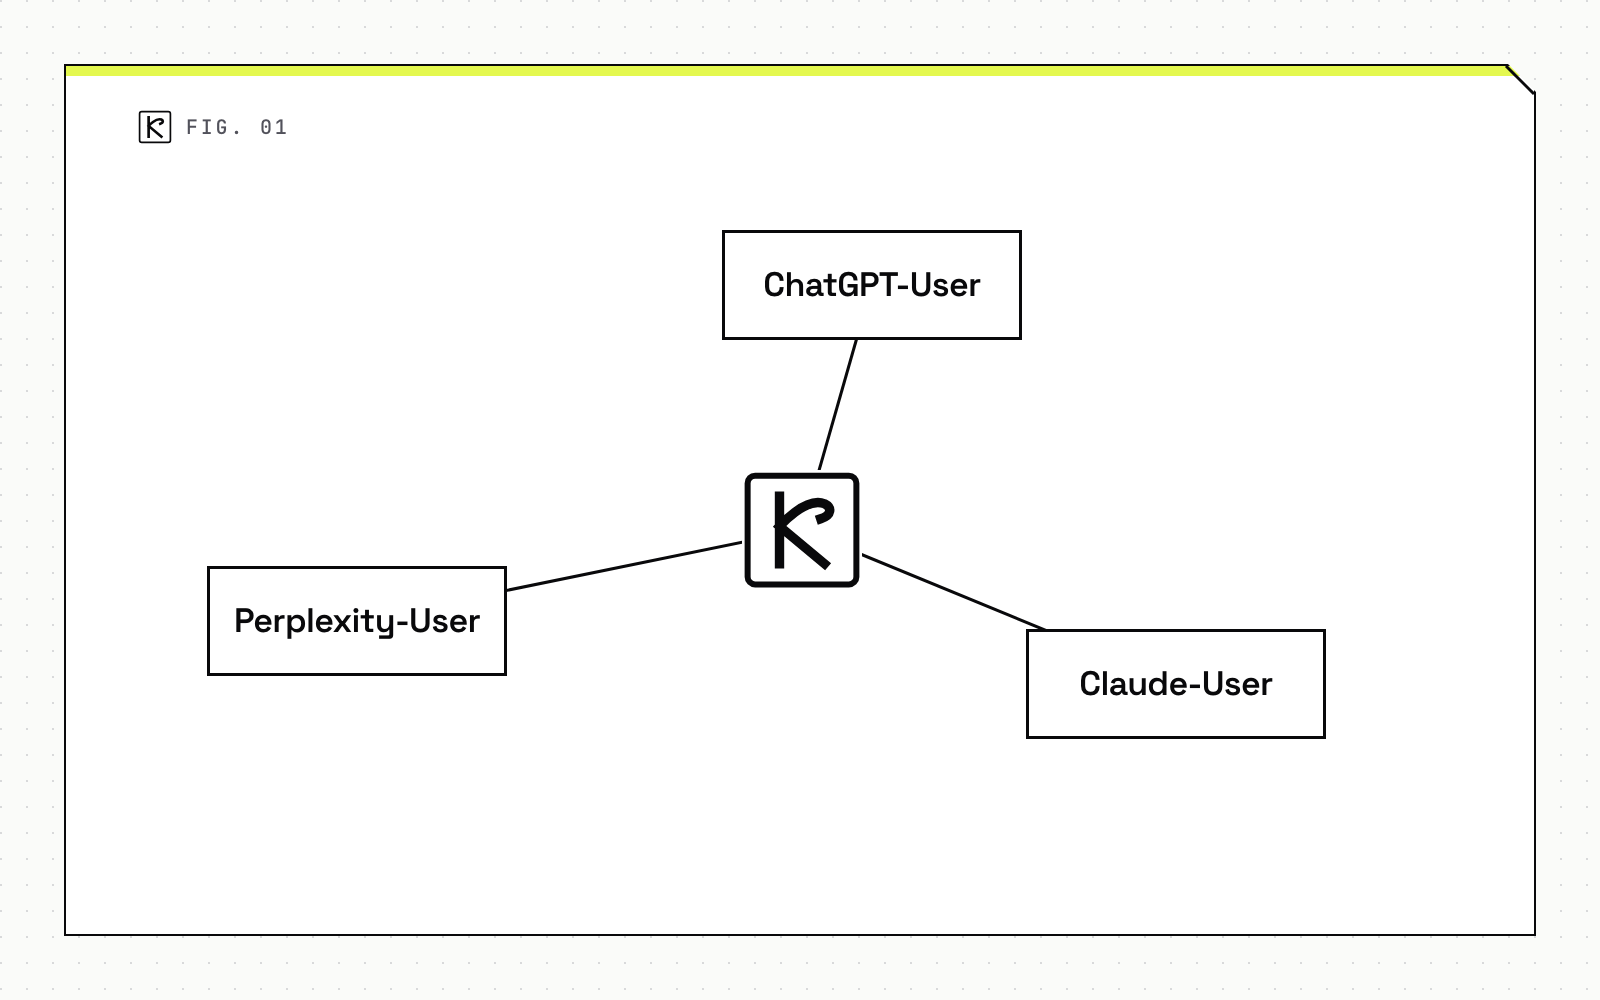
Los rastreadores de entrenamiento recopilan contenido para mejorar un modelo fundacional. GPTBot y ClaudeBot están aquí, junto con Google-Extended y Bytespider. Los rastreadores de búsqueda e indexación alimentan la propia función de respuesta o búsqueda de un producto de IA, separada del entrenamiento: OAI-SearchBot, Claude-SearchBot y PerplexityBot cumplen este papel. Los captadores activados por el usuario obtienen una sola página porque un usuario en vivo le pidió a un asistente que la mirara en ese momento, algo que la orientación del sector trata como distinto del rastreo automático: ChatGPT-User, Claude-User y Perplexity-User.
¿Por qué importa la distinción? Porque las tres categorías se controlan de forma independiente. Puedes bloquear el bot de entrenamiento de una empresa y, al mismo tiempo, permitir que su bot de búsqueda siga recorriendo tus páginas. Eso mantiene tu contenido fuera del entrenamiento del modelo mientras sigue siendo elegible para citarse en una respuesta de IA. Cubrimos el lado de las citas con más detalle en cómo conseguir que ChatGPT, Perplexity y Google AI Overviews te citen.
Cómo funciona en la práctica
Cada empresa publica sus propios nombres de user agent, sus propios rangos de IP y su propia sintaxis de robots.txt. Ninguna de las tres trata "bloquear a la empresa de IA" como un único interruptor.
Los cuatro bots de OpenAI
OpenAI documenta cuatro rastreadores distintos. GPTBot se usa para hacer que los modelos fundacionales de IA generativa de OpenAI sean más útiles y seguros, lo cual es entrenamiento. OAI-SearchBot muestra sitios web en los resultados de búsqueda de ChatGPT, una función separada del entrenamiento. OAI-AdsBot valida la seguridad de las páginas enviadas como anuncios, y OpenAI declara explícitamente que los datos que recopila no se usan para entrenar modelos fundacionales de IA generativa. ChatGPT-User maneja acciones que un usuario en vivo activa dentro de ChatGPT, como pegar una URL, y no se usa para rastreo automático. Cada bot publica su propio rango de IP como un archivo JSON. OpenAI indica que un cambio en robots.txt puede tardar unas 24 horas en llegar a sus sistemas.
Para bloquear solo GPTBot, dejando abierto el acceso de búsqueda:
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /
Los tres bots de Anthropic
Anthropic opera ClaudeBot, Claude-User y Claude-SearchBot, y cada uno cumple una función distinta. ClaudeBot recopila contenido web para entrenamiento. Claude-User obtiene una página solo cuando un usuario en vivo le hace a Claude una pregunta sobre ella. Claude-SearchBot indexa contenido para las funciones de búsqueda de Claude. Para limitar la velocidad en lugar de bloquear por completo un bot, la propia guía de Anthropic da esta sintaxis:
User-agent: ClaudeBot
Crawl-delay: 1
Para bloquearlo por completo, sustituye la segunda línea por Disallow: /. Anthropic publica los rangos de IP de sus rastreadores en claude.com/crawling/bots.json, aunque también señala que bloquear solo por dirección IP no es fiable, ya que los rangos cambian.
Los dos bots de Perplexity
Perplexity opera la misma división en miniatura: PerplexityBot es su rastreador de búsqueda e indexación, y Perplexity-User es el captador bajo demanda activado por una consulta en vivo, el mismo papel que ChatGPT-User y Claude-User cumplen para sus respectivas empresas. Como con los demás, cada nombre tiene su propia línea de User-agent.
Configurar bien estos ajustes forma parte del mismo trabajo técnico de SEO y AEO que hacemos para nuestros clientes. Consulta nuestro trabajo de SEO y AEO para ver cómo encaja la auditoría.
Ventajas, desventajas y casos límite
robots.txt solo funciona si el operador del rastreador lee el archivo y decide cumplirlo. Vale la pena decirlo con claridad, porque la brecha entre publicar una política de robots.txt y realmente seguirla se convirtió en una disputa pública en 2025.
robots.txt es una convención, no un candado
El archivo no tiene mecanismo de cumplimiento forzoso. Se originó en 1994 y solo se convirtió en un estándar formal, RFC 9309, en septiembre de 2022, casi tres décadas después. Un rastreador cumplidor revisa el archivo antes de recorrer una página. Uno que no cumple, no tiene por qué hacerlo.
La disputa con Perplexity
Cloudflare informó el 4 de agosto de 2025 que, después de que un sitio bloqueara al rastreador declarado de Perplexity mediante robots.txt o reglas de red, el tráfico de Perplexity seguía llegando de todos modos, a través de rastreadores no declarados que rotaban direcciones IP y cadenas de user agent. Cloudflare dijo haber observado el patrón en decenas de miles de dominios, lo que equivale a millones de solicitudes por día, y retiró a Perplexity de su programa de bots verificados como resultado. Perplexity cuestionó la caracterización, calificó el informe de maniobra publicitaria y argumentó que Cloudflare mezclaba solicitudes legítimas activadas por el usuario con rastreo autónomo. En cualquier caso, el episodio muestra algo simple: una regla de robots.txt es una solicitud que un operador cumplidor respeta, no un muro que todo operador respeta.
Quién bloquea qué en realidad
Ahrefs analizó cerca de 140 millones de sitios y publicó sus resultados el 21 de mayo de 2025. GPTBot fue bloqueado por el 5.89% de los sitios, ClaudeBot por el 5.74%, Google-Extended por el 5.71% y PerplexityBot por el 5.61%. La tasa de bloqueo de ClaudeBot creció un 32.67% en el año anterior, el crecimiento más rápido de cualquier rastreador que Ahrefs midió. robots.txt es una palanca entre varias. Combinarlo con un archivo específico para IA se explica en llms.txt explicado.
Preguntas frecuentes
¿Bloquear GPTBot en robots.txt elimina mi sitio de las respuestas de ChatGPT?
No. GPTBot y OAI-SearchBot son rastreadores de OpenAI separados, con tokens de robots.txt separados. Bloquear GPTBot mantiene tu contenido fuera del entrenamiento del modelo, mientras que OAI-SearchBot puede seguir recorriendo tus páginas para la función de búsqueda de ChatGPT. El acceso de entrenamiento y el de citación se controlan de forma independiente.
¿Es robots.txt legalmente vinculante para las empresas de IA?
No. robots.txt, estandarizado como RFC 9309 en septiembre de 2022, es una convención voluntaria. Rastreadores cumplidores como GPTBot y ClaudeBot lo revisan antes de recorrer una página, pero no conlleva ningún mecanismo de cumplimiento forzoso. Eso explica en parte por qué el informe de Cloudflare de agosto de 2025 sobre los rastreadores no declarados de Perplexity se convirtió en noticia.
¿Cuál es la diferencia entre ClaudeBot, Claude-User y Claude-SearchBot?
ClaudeBot recopila contenido web para entrenar los modelos de Anthropic. Claude-User obtiene una página específica solo cuando un usuario en vivo le pregunta a Claude sobre ella. Claude-SearchBot indexa contenido para las funciones de búsqueda de Claude. Cada uno tiene su propio token de User-agent, así que un sitio puede bloquear el entrenamiento mientras permite los otros dos.
¿Cómo bloqueo a la vez a todos los rastreadores de IA conocidos?
No existe un único token comodín que cubra de forma fiable a todos los bots de IA, ya que aparecen nuevos con regularidad. Agrega bloqueos explícitos de User-agent para los nombres principales actuales (GPTBot, ClaudeBot, PerplexityBot, Google-Extended, Bytespider, CCBot y sus equivalentes activados por usuario) y revisa la lista periódicamente: el número de bots de IA distintos prácticamente se duplicó entre agosto de 2023 y diciembre de 2024.
¿Por qué Cloudflare retiró a Perplexity de su programa de bots verificados?
Cloudflare informó el 4 de agosto de 2025 que, tras ser bloqueado por las reglas de robots.txt o de red de un sitio, el tráfico de Perplexity continuaba mediante rastreadores no declarados y sigilosos que rotaban direcciones IP y user agents, en decenas de miles de dominios. Perplexity cuestionó la caracterización, alegando que Cloudflare mezclaba solicitudes legítimas activadas por el usuario con rastreo autónomo.
Bloquear el entrenamiento mientras se conserva el acceso de citación, bot por bot, es la versión práctica de esta decisión. El límite más difícil es que robots.txt es una solicitud, no un muro, y la lista de bots que preguntan sigue cambiando. Combinar esa decisión con una estrategia más amplia de optimización para motores de respuesta asegura que bloquear el entrenamiento nunca te cueste citas sin que te des cuenta.