Privacidad de datos en APIs de LLM en 2026: retención cero, residencia y condiciones del proveedor
Los dos grandes proveedores conservan los datos de la API hasta 30 días por defecto. La retención cero requiere aprobación, cubre solo algunos endpoints y la residencia separa almacenamiento de procesamiento.
Por defecto, tanto OpenAI como Anthropic conservan las entradas y salidas de la API hasta 30 días. La retención cero de datos (ZDR, por sus siglas en inglés) es un acuerdo aprobado, no un ajuste que se activa, y cubre solo algunos endpoints y funciones. Esta guía se basa en la documentación propia de los proveedores a octubre de 2026. Revisa tu contrato antes de prometerle algo a un cliente.
Por qué la privacidad de datos en APIs de LLM se reduce a cuatro preguntas
Un cliente pregunta: "¿El modelo guarda nuestros datos?". La respuesta honesta depende de cuatro cosas.
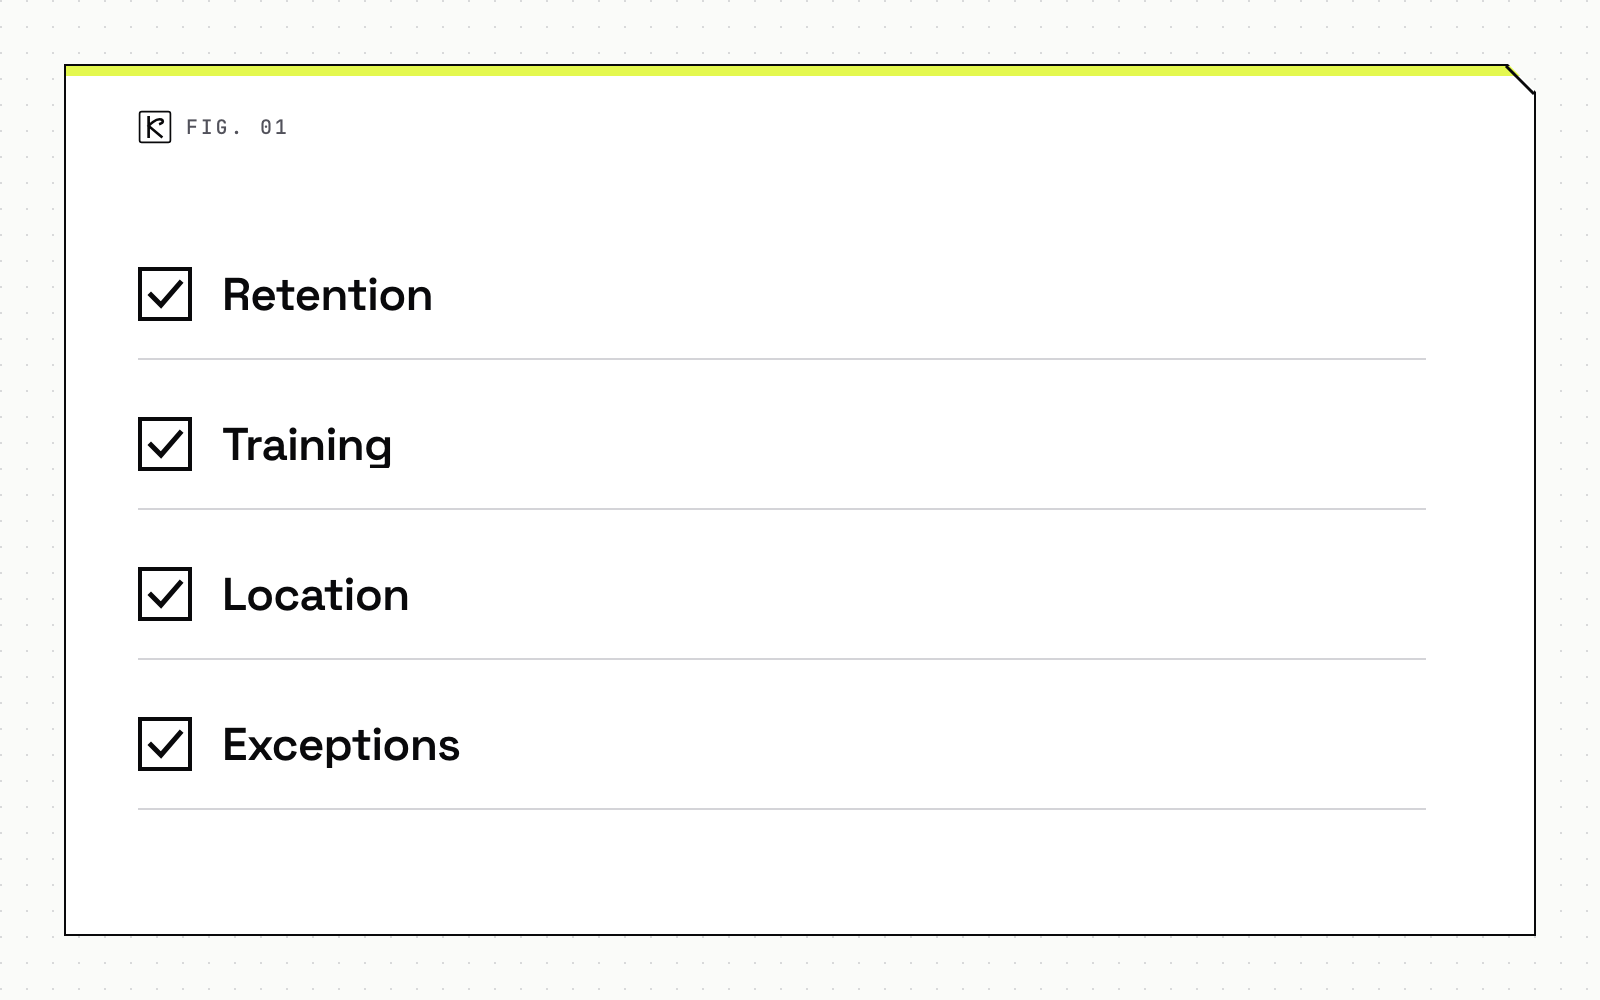
- Retención: cuánto tiempo almacena el proveedor tus prompts y respuestas.
- Entrenamiento: si esos datos se usan para mejorar los modelos.
- Ubicación: dónde se procesan las solicitudes y dónde quedan los datos en reposo.
- Excepciones: qué funciones quedan fuera de la promesa que te hicieron.
Trátalas como cuatro controles separados. Cada proveedor documenta cada uno en un lugar distinto, y una buena respuesta en uno no dice nada sobre los demás.
La retención y el entrenamiento son controles distintos
La retención trata del almacenamiento. El entrenamiento trata del uso. En las conversaciones con clientes se confunden constantemente.
Retención por defecto
Anthropic indica que elimina automáticamente de su backend las entradas y salidas de la API "within 30 days of receipt or generation", es decir, en un plazo de 30 días desde su recepción o generación. Las excepciones que enumera son el almacenamiento de la Files API, acuerdos como la retención cero, la aplicación de su Usage Policy y los requisitos legales. El artículo tiene fecha del 1 de julio de 2026.
OpenAI describe registros de monitoreo de abuso que se generan para todo uso de las funciones de la API. Pueden contener prompts, respuestas y metadatos derivados. Se conservan hasta 30 días, salvo que la ley exija una retención más larga o que haga falta para proteger los servicios o a terceros de un daño.
Entrenamiento
OpenAI afirma que los datos enviados a la API no se usan para entrenar ni mejorar sus modelos salvo que aceptes expresamente compartirlos, con efecto desde el 1 de marzo de 2023. La página de retención de Anthropic se compromete a que los datos retenidos nunca se usan para entrenar modelos sin tu permiso expreso.
El contenido marcado se conserva más tiempo
La retención cero no borra todo. Si los sistemas automáticos de confianza y seguridad de Anthropic marcan una conversación, las entradas y salidas pueden conservarse hasta 2 años, y las puntuaciones de clasificación hasta 7 años. OpenAI señala que algunas entradas marcadas pueden retenerse para revisión incluso con ZDR o Modified Abuse Monitoring activados.
Qué cubre la retención cero de datos
ZDR significa que el proveedor no almacena tus prompts ni tus respuestas una vez devuelta la respuesta. Los detalles cambian según el proveedor, y nada de esto es automático.
Se aprueba, no se activa
OpenAI ofrece dos controles que excluyen el contenido del cliente de los registros de abuso: Zero Data Retention y Modified Abuse Monitoring. Ambos están sujetos a la aprobación previa de OpenAI y a la aceptación de requisitos adicionales, y para comprobar la elegibilidad hay que contactar con ventas. Con ZDR, el parámetro store de /v1/responses y /v1/chat/completions siempre se trata como false.
El ZDR de Anthropic se revisa y se aplica organización por organización. Se aplica a las APIs Messages y Token Counting para las funciones elegibles, y las interfaces de producto de Claude Teams y Claude Enterprise no son elegibles para ZDR.
Depende del endpoint
OpenAI indica que estos endpoints son elegibles para ZDR, con limitaciones: /v1/responses, /v1/chat/completions, /v1/images, /v1/embeddings, /v1/audio, /v1/moderations, /v1/realtime y /v1/completions. Y señala que estos no lo son porque guardan estado de la aplicación, a menudo hasta que lo borras: /v1/files, /v1/batches, /v1/fine_tuning/jobs, /v1/vector_stores, /v1/conversations y los endpoints de Assistants y Threads.
El modelo también puede cambiar la respuesta
Anthropic designa Claude Fable 5.1, Claude Mythos 5.1, Claude Fable 5 y Claude Mythos 5 como Covered Models. Exigen 30 días de retención de datos y no están disponibles con ZDR salvo que Anthropic lo autorice expresamente. Una organización sin el ajuste de retención requerido recibe un 400 invalid_request_error. Una organización con ZDR puede activar la retención de 30 días solo en un workspace, y los demás workspaces conservan la retención cero.
Funciones que se salen de la retención cero sin que lo notes
Lo arriesgado de ZDR suele ser la función que añades después. La tabla de elegibilidad de Anthropic dice que las funciones marcadas con "No" suelen tener estado, y que la API no las bloquea bajo ZDR. Usar una es decidir salirte de tu acuerdo para esos datos.
- Procesamiento por lotes (batch): 29 días de retención, porque requiere almacenamiento asíncrono.
- Files API: los archivos se conservan hasta que los borres o caduquen.
- Ejecución de código: los datos del contenedor se retienen hasta 30 días.
- Conector MCP y agent skills: los datos se retienen según la política estándar.
Algunas funciones son elegibles con una huella pequeña. El prompt caching no almacena prompts ni respuestas, y sus representaciones de caché se mantienen en memoria durante el TTL de la caché. Las salidas estructuradas figuran como "Yes (qualified)": solo se almacena en caché el esquema JSON, hasta 24 horas desde su último uso. Si enrutas tráfico con caché y enrutamiento de modelos, compara cada función con la tabla antes de activarla.
Residencia de datos: dónde se ejecuta frente a dónde se almacena
La residencia tiene dos mitades, y cada proveedor las nombra de forma distinta.
Anthropic
La página de residencia de datos de Anthropic separa dos ajustes.
- Inference geo fija dónde se ejecuta la inferencia, por solicitud o como valor por defecto del workspace.
"us"mantiene la inferencia en infraestructura de EE. UU., y el valor por defecto"global"permite cualquier zona geográfica. Requiere Claude 4.6 o posterior, y la inferencia solo en EE. UU. cuesta 1,1 veces la tarifa estándar. - Workspace geo fija dónde se almacenan los datos en reposo. Se define al crear el workspace y no se puede cambiar después; hoy solo está disponible
"us".
OpenAI
OpenAI lista Estados Unidos y Europa (EEE más Suiza) para almacenamiento y procesamiento. Australia, Canadá, Japón, India, Singapur, Corea del Sur y el Reino Unido son solo de almacenamiento. Los Emiratos Árabes Unidos ofrecen almacenamiento y procesamiento con aprobación adicional. Las regiones fuera de EE. UU. requieren aprobación para Modified Abuse Monitoring o ZDR y una enmienda de Modified Retention.
Rutas a través de proveedores de nube
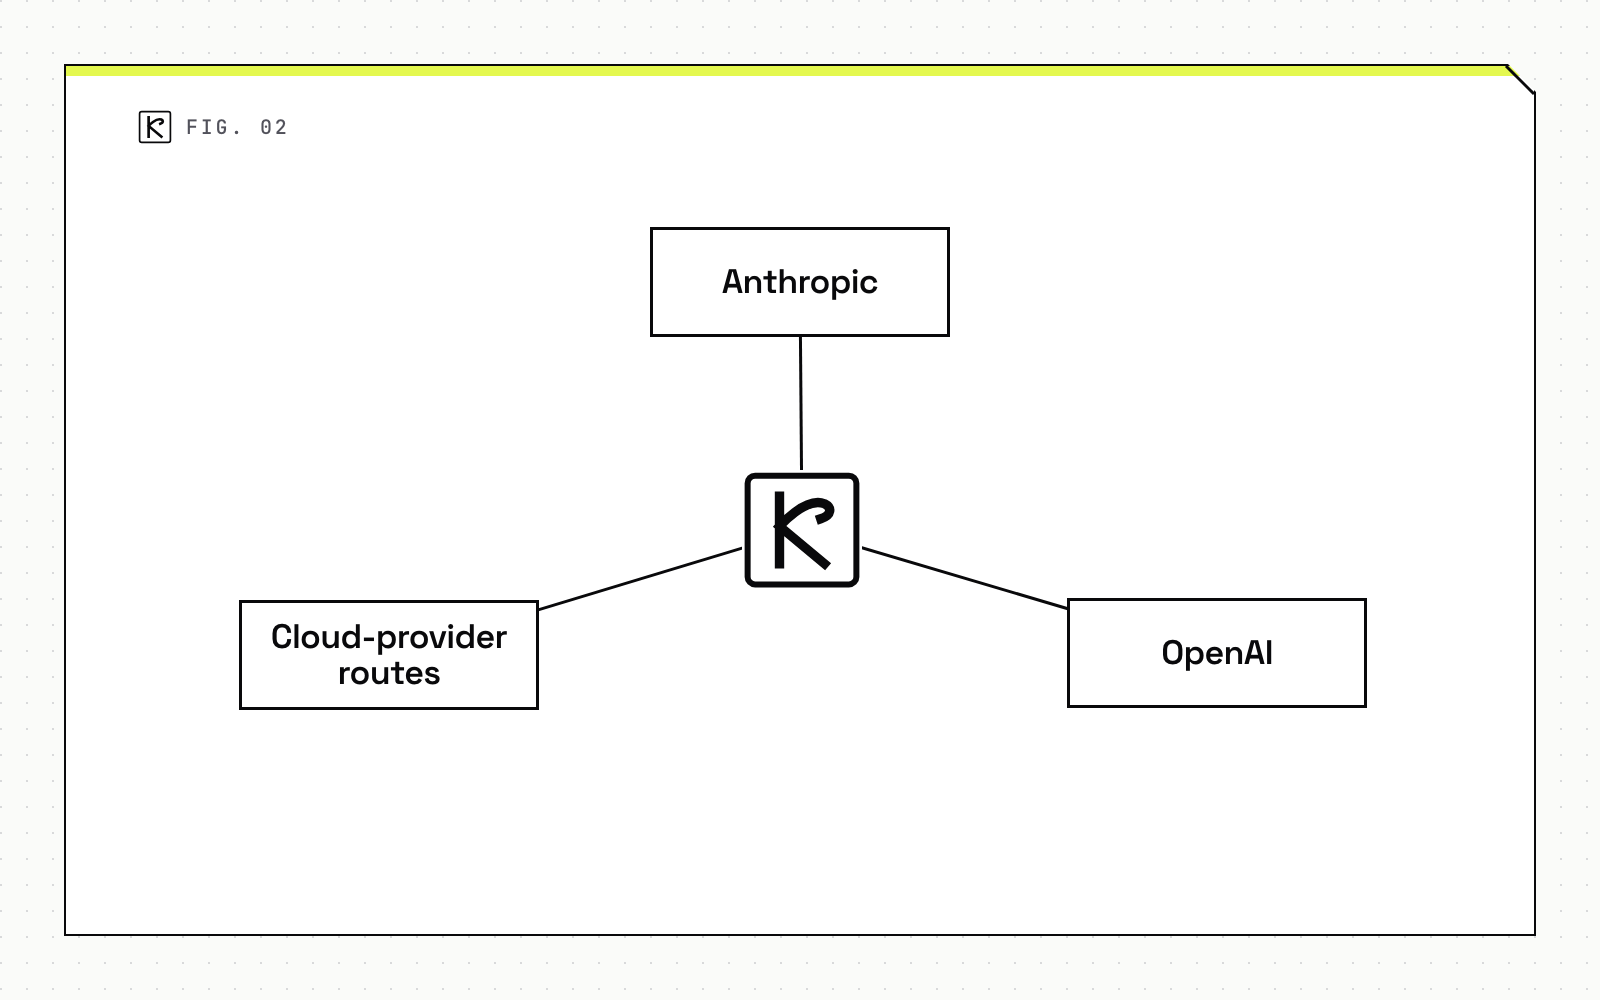
En Amazon Bedrock y Google Cloud, el proveedor de nube es el encargado del tratamiento de los datos de Claude, así que se aplican sus propias condiciones de retención y cumplimiento. La región depende del endpoint o del perfil de inferencia, no de inference_geo.
Lista de comprobación antes de lanzar
Repasa esto antes de decirle a un cliente que sus datos están protegidos.
- Consigue el acuerdo por escrito, por endpoint y por modelo. "ZDR activado" no es lo bastante concreto.
- Compara cada función que uses con la tabla de elegibilidad del proveedor. Archivos, lotes y ejecución de código son las fugas habituales.
- Elige la residencia al crear el proyecto o el workspace. El workspace geo de Anthropic no se puede cambiar después.
- Envía menos. El control más barato es no poner identificadores en el prompt. En cómo elegir un modelo para una función de producto tienes el resto de las contrapartidas.
- Mantén a una persona en las acciones sensibles. Qué acciones de un agente necesitan a una persona explica dónde trazar esa línea.
- Vuelve a leer las condiciones cada trimestre. Las páginas de los proveedores llevan fechas de 2026, como el artículo de retención de Anthropic del 1 de julio de 2026, y la lista de Covered Models puede cambiar.
Si estás definiendo una función de IA y necesitas esto mapeado para un cliente concreto, escríbenos.
Preguntas frecuentes
¿Una API de LLM entrena con mis datos por defecto?
No, según la documentación actual de ambos proveedores. OpenAI dice que los datos de la API no se usan para entrenar salvo que lo aceptes, y Anthropic dice que los datos retenidos nunca se usan para entrenar sin permiso expreso. El entrenamiento es un control distinto de la retención.
¿La retención cero de datos es automática?
No. ZDR y Modified Abuse Monitoring de OpenAI requieren aprobación previa y requisitos adicionales, y Anthropic aplica ZDR por organización mediante un acuerdo. Pregunta al proveedor antes de asumir que cubre tu cuenta.
¿La residencia de datos significa que mis datos nunca salen de una región?
No necesariamente. Los proveedores separan el almacenamiento del procesamiento. OpenAI lista varias regiones como solo de almacenamiento, y Anthropic distingue entre inference geo y workspace geo, así que lee cuál de los dos controla cada ajuste.
¿Quién es el encargado del tratamiento si uso Claude a través de Bedrock o Google Cloud?
El proveedor de nube. La documentación de Anthropic dice que el proveedor de nube es el encargado del tratamiento en Amazon Bedrock y Google Cloud, así que se aplican las condiciones de retención y cumplimiento de esa plataforma.