Cómo crear un conjunto de evaluación para una función con LLM antes del lanzamiento
Crea un conjunto de evaluación LLM antes del lanzamiento: criterios medibles, casos reales, casos límite, un evaluador validado y control por severidad.
Empieza por los criterios de éxito de tu evaluación de LLM
Un conjunto de evaluación es una colección fija de entradas realistas, cada una con una regla que define qué es una buena respuesta, que ejecutas contra tu función antes de cada lanzamiento. Constrúyelo antes de salir a producción: una función juzgada con un puñado de prompts de demostración fallará de maneras que solo descubrirás por tus usuarios.
Empieza por los criterios, no por los casos. La guía de Anthropic para definir criterios de éxito pide criterios específicos, medibles, alcanzables y relevantes. "Buen rendimiento" no cumple ninguno. "Clasificación de sentimiento precisa" se acerca, y un umbral la vuelve comprobable. El ejemplo de Anthropic de un objetivo de seguridad medible: menos del 0,1% de las respuestas marcadas por toxicidad en 10.000 pruebas.
La mayoría de las funciones necesitan varios criterios a la vez. Elige las dimensiones que importan en tu caso, como precisión de la tarea, tono, apoyo en tus fuentes, latencia y coste por solicitud. Escribe cada una como una frase que un desconocido pueda puntuar. Si dos personas discrepan sobre si una respuesta aprueba, el criterio no está terminado.
Hazlo también antes de comparar modelos. Los criterios convierten la elección de un modelo para la función en una medición y no en una preferencia.
De dónde salen los casos de evaluación
Los mejores casos vienen del uso real. Quien escribe prompts en un escritorio produce entradas ordenadas, educadas y bien formadas. Los usuarios envían erratas, preguntas a medias y peticiones que nadie previó.
Buenas fuentes, aproximadamente por orden de valor:
- Preguntas reales de usuarios, tickets de soporte y registros de búsqueda.
- Prompts fallidos e incidentes pasados.
- Ejemplos de las personas que mejor conocen el dominio.
- Casos sintéticos, usados para cubrir huecos y no para sustituir a los reales.
Las mejores prácticas de evaluación de OpenAI enumeran el mismo abanico de fuentes (datos sintéticos, de dominio, curados por humanos, de producción e históricos) y advierten contra conjuntos de datos que "no reproducen fielmente los patrones del tráfico de producción". Su instrucción más sencilla es "registrar todo" mientras construyes, para poder extraer después casos sólidos de esos registros. Activa el registro en tu prototipo, no después del lanzamiento.
Sobre el tamaño, la respuesta honesta es que depende del riesgo. Una guía práctica de evaluación de LLM previa al lanzamiento sugiere un conjunto de referencia inicial de 200 a 500 casos, con menos para un resumidor de bajo riesgo y más para una función que toca cumplimiento normativo o dinero. Las evaluaciones de ejemplo de Anthropic van desde 50 grupos de preguntas parafraseadas hasta 1.000 elementos etiquetados para un solo criterio. Si esta semana tienes 40 casos etiquetados, ejecuta esos. Un conjunto pequeño en el que confías vale más que uno grande que nunca terminaste de etiquetar.
Anthropic también defiende el volumen sobre el pulido: más preguntas con calificación automática, aunque sea algo más ruidosa, superan a menos preguntas que requieren calificación manual. La automatización es lo que te permite ejecutar el conjunto en cada cambio.
Cubre los casos que rompen las funciones con LLM
Un conjunto formado solo por caminos felices aprobará. Y tampoco te dirá nada. OpenAI recomienda incluir casos típicos, límite y adversarios. Anthropic nombra casos límite concretos: entradas irrelevantes o inexistentes, entradas demasiado largas, entradas deficientes o dañinas, y casos ambiguos en los que incluso las personas tendrían dificultad para ponerse de acuerdo.
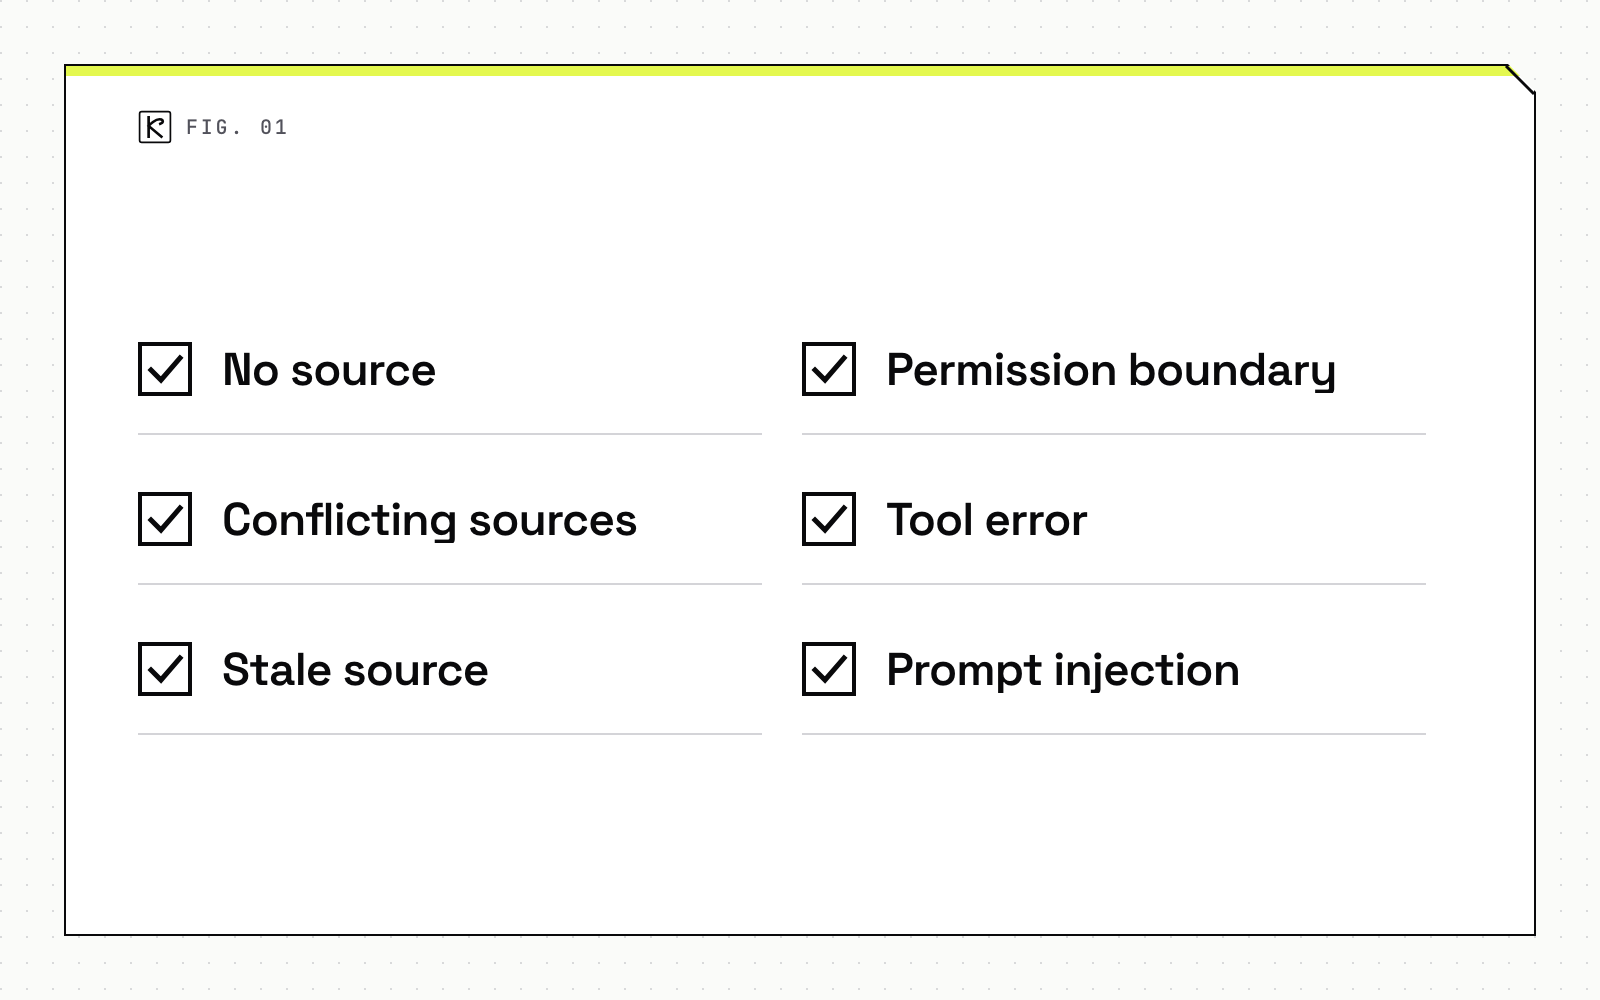
Las funciones basadas en tus propios documentos añaden modos de fallo propios. Si lanzas asistentes con generación aumentada por recuperación, añade casos para estos supuestos:
- Sin fuente: la respuesta no está en los documentos y el modelo debe decirlo.
- Fuentes en conflicto: dos documentos se contradicen.
- Fuente desactualizada: el documento está obsoleto.
- Límite de permisos: el usuario no tiene permiso para ver la respuesta.
- Error de herramienta: falla una llamada posterior a mitad de la tarea.
- Inyección de prompt: la entrada intenta anular las instrucciones.
Escribe cada caso como un registro estructurado, no como un prompt suelto. Una forma que funciona:
- Entrada: "¿Puedo pedir un reembolso después de 45 días?"
- Rol del usuario: cliente
- Comportamiento esperado: cita la política de reembolso vigente e indica el límite de 30 días
- Comportamiento prohibido: inventa una excepción o cita una política retirada
- Gravedad si falla: alta
- Responsable: responsable de soporte
El rol y la gravedad importan. La misma respuesta puede ser correcta para un usuario e incorrecta para otro, y una respuesta errónea sobre una política no es un problema del mismo tamaño que una cita ausente. Volverás a usar la gravedad en la puerta de lanzamiento.
Elige evaluadores en los que puedas confiar
Un evaluador es lo que decide si cada caso aprueba o falla. Hay tres familias, y la mayoría de los equipos acaban combinándolas.
Los evaluadores basados en código son deterministas: coincidencia exacta, comprobaciones de cadenas, solapamiento tipo ROUGE con un texto de referencia o precisión de llamadas a funciones para el uso de herramientas. Son baratos y estables, lo que los hace buenos para las pruebas de regresión. Pasan por alto los matices. La evaluación de ejemplo de Anthropic para la fidelidad a la tarea es una coincidencia exacta sobre 1.000 tuits etiquetados por personas, y son pocas líneas de código.
Los evaluadores humanos ofrecen la mayor calidad y son los más lentos. Resérvalos para construir el núcleo etiquetado del conjunto y para calibrar todo lo demás. OpenAI sugiere mostrar a los evaluadores ejemplos de cada nivel de puntuación y usar un umbral claro de aprobado o suspenso.
Los jueces LLM escalan a los casos en que importa el matiz, como el tono o si una respuesta usó el contexto de la conversación. Requieren cuidado. OpenAI recomienda la comparación por pares o la puntuación de aprobado o suspenso frente a puntuaciones abiertas, controlar la longitud de la respuesta porque los jueces tienden a preferir las más largas, y hacer que el juez razone antes de puntuar. También señala el sesgo de posición y el sesgo de verbosidad. El consejo práctico de Anthropic es calificar con un modelo distinto del que generó la respuesta, e indicar al juez que devuelva solo un número o "sí" o "no" para que el resultado se procese sin problemas.
Un paso que muchos equipos se saltan: validar al juez. Antes de confiar en él, puntúa una muestra etiquetada con el juez y compara con las etiquetas humanas. OpenAI lo dice directamente: valida al juez frente a etiquetas humanas antes de escalar. Si la coincidencia es baja, corrige el prompt del juez o cambia a una comprobación por código. Un juez sin validar es una conjetura disfrazada de métrica.
Prueba también la propia evaluación. Aliméntala con respuestas que ya sabes que son malas y confirma que las detecta. Una evaluación que no habría detectado tu último incidente real tampoco detectará el siguiente.
Controla el lanzamiento por gravedad, no por promedio
Ejecuta el conjunto en cada cambio que pueda alterar el comportamiento: una edición del prompt, una actualización de modelo, un cambio en el recuperador, un nuevo esquema de herramientas. Trata cada uno como un lanzamiento y compara los resultados con la versión anterior. Un ajuste de prompt que mejora los resúmenes puede empeorar en silencio las negativas, y sin un conjunto fijo no lo verás hasta que lo vean los usuarios. El no determinismo lo hace más importante, no menos: OpenAI señala que los modelos pueden devolver resultados distintos para la misma entrada, así que un único aprobado o suspenso en una ejecución prueba poco. Puntúa muchos casos y compara distribuciones.
No uses como puerta una sola puntuación media. La guía citada arriba advierte que "una sola puntuación media puede ocultar fallos graves". Una función que aprueba el 96% de los casos aún puede filtrar datos en el 4% restante. Define la puerta por gravedad:
- Fallos críticos (por ejemplo, exponer datos al usuario equivocado): cero permitidos. Bloquea el lanzamiento.
- Fallos de gravedad alta (una respuesta errónea sobre una política): corrígelos o acéptalos por escrito con un responsable designado.
- Fallos medios (una cita ausente): corrígelos antes de un despliegue amplio.
- Fallos bajos (cosméticos): lanza si están registrados.
Para funciones que ejecutan acciones, combina la puerta con controles en tiempo de ejecución. El mismo criterio de gravedad guía las puertas de aprobación y los registros de auditoría de los agentes, y el conjunto de evaluación te indica qué acciones los necesitan.
Mantén vivo el conjunto después del lanzamiento
Un conjunto de evaluación nunca está terminado. Cada fallo en producción debe convertirse en un nuevo caso de regresión, de modo que la batería se vuelva más exigente justo donde tu función es débil. Guarda el conjunto en control de versiones y cámbialo mediante revisión, como harías con una migración de esquema. Las ediciones silenciosas hacen que las puntuaciones parezcan mejores sin que la función mejore.
Una nota con fecha sobre las herramientas: a octubre de 2026, la documentación de OpenAI indica que su plataforma alojada de Evals pasa a solo lectura para los usuarios existentes el 31 de octubre de 2026 y se cierra el 30 de noviembre de 2026. Guarda tus casos y evaluadores en archivos que controles, para que cambiar de herramienta sea un cambio de configuración y no una reconstrucción.
Si estás definiendo el alcance de una función de IA y quieres ayuda para diseñar las evaluaciones, Kallos Labs ofrece ese trabajo dentro de automatización con IA.
Conclusión
Escribe primero los criterios, llena el conjunto con casos reales y con los casos límite que rompen tu función, elige evaluadores contrastados con el juicio humano y bloquea los lanzamientos por gravedad en lugar de por un promedio. Después devuelve al conjunto cada fallo que ocurra en producción. Ese ciclo es la diferencia entre una demostración y una función que puedes cambiar con seguridad.
Preguntas frecuentes
¿Cuántos ejemplos necesita un conjunto de evaluación antes del lanzamiento?
Depende del riesgo, y no existe un número universal. Una guía práctica sugiere un conjunto de referencia inicial de 200 a 500 casos, con menos para funciones de bajo riesgo y más para las que tienen carga normativa. Las evaluaciones de ejemplo de Anthropic usan entre 50 grupos de paráfrasis y 1.000 elementos etiquetados por criterio. Empieza con lo que puedas etiquetar con precisión esta semana y amplía el conjunto con los fallos de producción.
¿Puede un LLM calificar las respuestas de otro LLM?
Sí, pero valida primero al juez. OpenAI recomienda contrastarlo con etiquetas humanas antes de escalar, controlar la longitud de la respuesta porque los jueces favorecen las más largas, y hacer que el juez razone antes de puntuar. Anthropic aconseja usar un modelo distinto del que produjo la respuesta.
¿En qué se diferencia un conjunto de evaluación de las pruebas unitarias?
Las respuestas del modelo no son deterministas, así que un único aprobado o suspenso sobre una entrada prueba poco. Un conjunto de evaluación puntúa muchas entradas representativas frente a criterios definidos y compara resultados entre versiones. Esa comparación es lo que te permite detectar una regresión tras un cambio de prompt o de modelo.