Controles de seguridad para agentes de IA: permisos, aprobaciones y registros de auditoría
Los controles de seguridad para agentes de IA son permisos, aprobaciones y registros de auditoría aplicados fuera del modelo. Así se configuran, y así fallan los equipos.
Respuesta directa
Los controles de seguridad para agentes de IA se reducen a tres mecanismos separados: permisos delimitados sobre las herramientas que un agente puede invocar, puertas de aprobación que lo detienen antes de una acción irreversible, y registros de auditoría que documentan lo que hizo en realidad. Ninguno de los tres vive dentro del modelo. Según el Top 10 de OWASP para aplicaciones LLM de 2026, la Autonomía Excesiva subió del sexto al tercer puesto, el mayor salto de la nueva clasificación. Cada vez más agentes tienen acceso real a herramientas y permisos reales. Así que si le estás dando a un agente acceso de escritura a una base de datos, a un flujo de pagos o a mensajería saliente, estos tres controles son lo que separa una respuesta equivocada de una acción equivocada.
Antes de empezar
Un agente, en este contexto, es un modelo más un conjunto de herramientas que puede invocar por su cuenta, sin que una persona apruebe cada llamada de antemano. El Model Context Protocol se ha convertido en la forma habitual de exponer esas herramientas a un modelo de manera estructurada y detectable. Esa estructura es también lo que permite delimitarlas de forma consistente, en lugar de añadir una comprobación por cada integración una por una.
Conviene separar esto de un asunto relacionado pero distinto. La generación aumentada por recuperación trata de lo que el modelo lee antes de responder. Los controles de seguridad tratan de lo que puede hacer una vez que decide actuar. Un agente de soporte con una recuperación perfecta y una herramienta de reembolso sin delimitar sigue siendo un riesgo. Un agente de soporte sin recuperación alguna, pero con un conjunto de herramientas bien delimitado y con puertas de aprobación, no lo es.
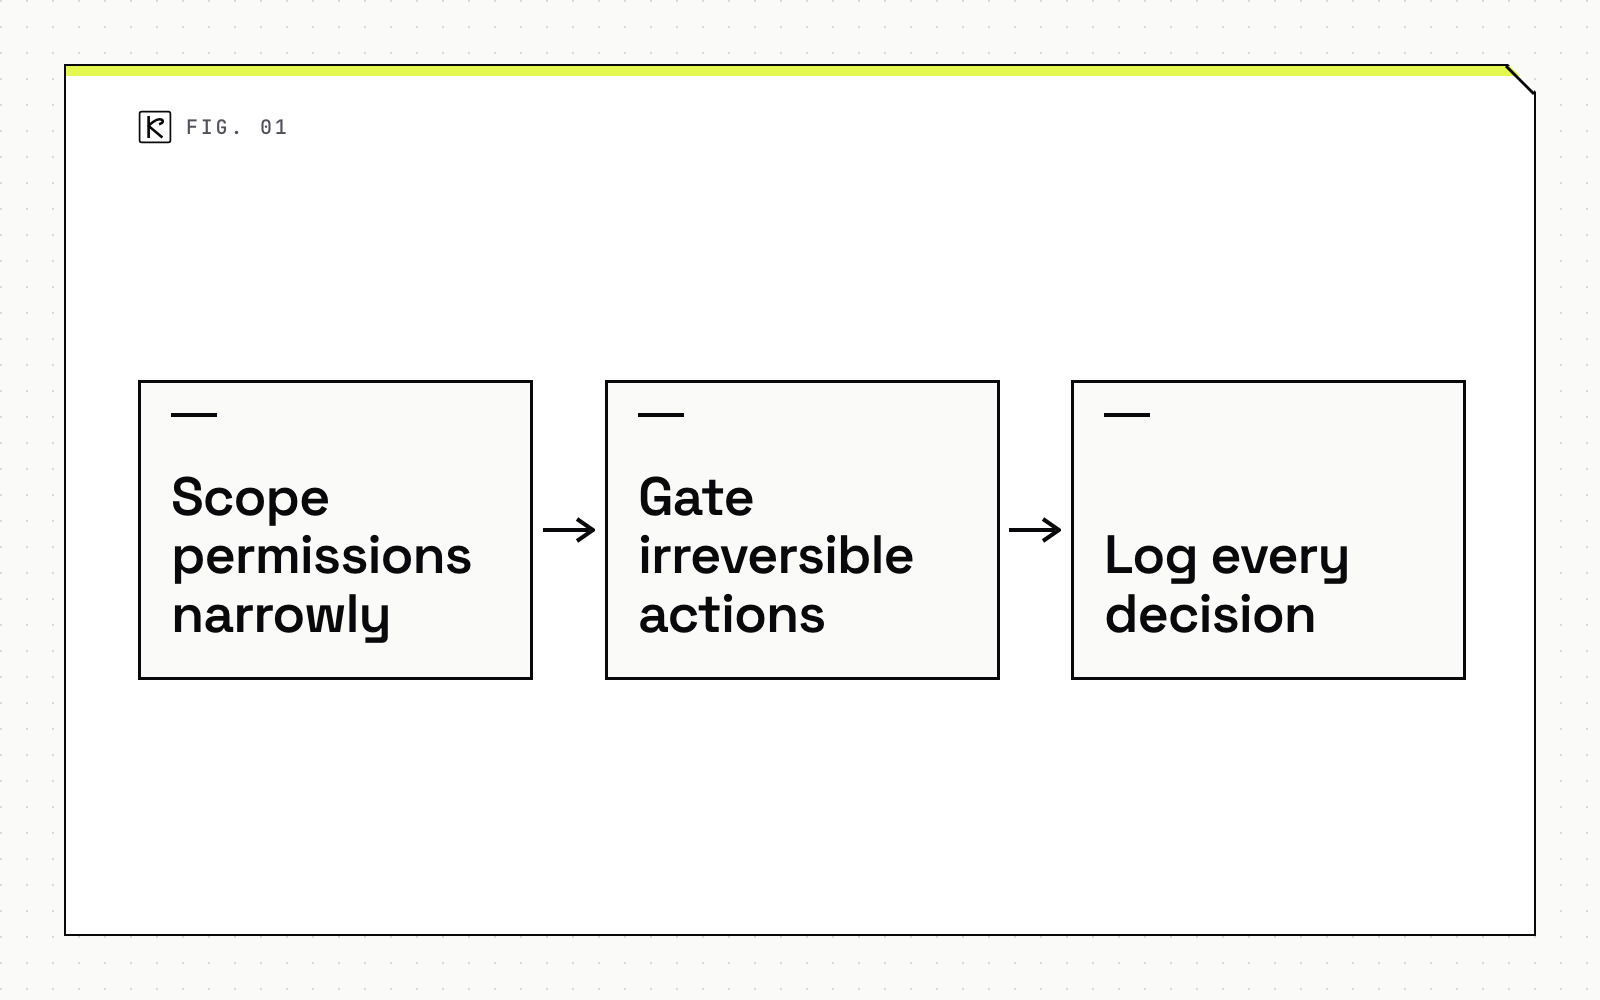
Debajo de los tres controles hay una sola regla, expresada con claridad en la especificación de MCP: siempre debería haber una persona en el circuito con la capacidad de denegar una invocación de herramienta. Los permisos, las puertas de aprobación y los registros de auditoría son tres puntos distintos donde esa regla se aplica de verdad: antes de que la llamada sea siquiera posible, en el momento de la llamada, y después de ella.
Paso a paso: construye los tres controles
Paso 1: delimita los permisos con precisión, no mediante el prompt. El control más fiable es el que hace que una acción sea imposible de realizar, no solo improbable. Eso significa separar lectura, escritura, borrado, exportación y envío en permisos independientes, otorgables uno por uno, en lugar de una sola herramienta amplia. ¿Por qué? Porque una herramienta que nunca fue registrada no puede ser invocada, sin importar lo que diga el prompt. Un agente que prepara reuniones recibe acceso de lectura al correo. No recibe también borrado y envío solo porque la API subyacente los agrupe.
La misma idea se aplica un nivel más abajo, en el propio almacén de datos. La seguridad a nivel de fila aplica ese mismo principio de delimitación estricta en la base de datos, de modo que incluso una llamada de agente comprometida o confundida se verifica contra una política que el agente no puede ver ni anular. Anotaciones de herramientas como readOnlyHint, destructiveHint, idempotentHint y openWorldHint pueden alimentar un motor de políticas que señale qué requiere una revisión más atenta, pero son indicios que un servidor reporta sobre sí mismo, no una aplicación real de la regla, y un servidor no confiable puede simplemente reportarlos de forma incorrecta.
Paso 2: condiciona las acciones irreversibles a una aprobación real. Algunas acciones no se pueden deshacer: pagos, borrados en producción, rotación de credenciales, el envío de un mensaje a alguien fuera de la organización. Estas necesitan un punto de control humano, no un umbral de confianza. Un patrón que funciona es la respuesta gradual: denegar automáticamente todo lo que esté claramente fuera de política y registrar el motivo, aprobar automáticamente las acciones rutinarias por debajo de un umbral definido, y enviar todo lo demás a una persona. Esta es la parte que los equipos suelen saltarse: hacer que la aprobación misma sea infalsificable. El registro de quién aprobó qué tiene que estar firmado, para que un cliente no pueda repetir después su propio historial de mensajes y fabricar una autorización que nunca existió.
Paso 3: registra cada decisión en un único punto de control, no herramienta por herramienta. La especificación de MCP también es clara en esto. Los clientes deberían registrar el uso de herramientas con fines de auditoría. La versión útil de ese registro se concentra en un único punto de control, capturando la latencia, qué control de seguridad se activó y el resultado, en lugar de estar disperso entre una decena de integraciones separadas donde una revisión de incidentes tiene que reconstruir la línea temporal a mano. Combina esto con límites estrictos que se apliquen antes de la siguiente llamada al modelo, no después de que el gasto ya haya ocurrido: un límite de pasos por defecto, y presupuestos separados para reintentos, tiempo transcurrido, llamadas a herramientas y coste del proveedor.
Errores comunes
El error que está detrás de la mayoría de los demás: dejar que el modelo juzgue si su propia acción está autorizada. No puede. OWASP es explícito en que la autorización tiene que situarse aguas abajo del modelo, aplicada de forma independiente a lo que haya concluido el LLM, porque una salida alucinada o manipulada es exactamente el detonante que convierte un permiso pensado para ser estrecho en un daño real.
Un segundo error es tratar una anotación de herramienta como una garantía. destructiveHint y readOnlyHint son señales útiles procedentes de un servidor de confianza. No son una barrera de seguridad, y un servidor con errores o malicioso puede reportarlas de forma incorrecta sin que nada aguas abajo lo note, hasta que lo hace el registro.
Un tercer error: construir una única herramienta que lo hace todo en lugar de delimitar por separado lectura, escritura, borrado y envío. Es cómodo durante el desarrollo, y significa que una sola inyección de prompt tiene un radio de impacto mucho mayor del que la tarea necesitaba.
Un cuarto error es registrar sin generar alertas. Un registro que nadie revisa hasta después de un incidente no es un control de seguridad. Es un informe forense posterior.
El salto de OWASP en 2026, del sexto al tercer puesto, es la versión a escala de toda la industria del mismo error: los despliegues de agentes se adelantaron a los controles pensados para contenerlos. Es también la razón por la que existe el recién donado Agent Control Standard del proyecto, que cubre identidad, gobernanza, pruebas y controles en tiempo de ejecución como una base compartida, en lugar de dejar que cada equipo reinvente la suya. Kallos Labs incorpora este mismo proceso de revisión, permisos delimitados, un paso de aprobación firmado y un único registro de auditoría, en cada proyecto de agentes de IA y automatización que entrega.
Preguntas frecuentes
¿Qué son los controles de seguridad para agentes de IA?
Los controles de seguridad para agentes de IA son los permisos delimitados, los puntos de control de aprobación y los mecanismos de registro que limitan lo que un agente autónomo puede hacer y crean un registro de lo que hizo, aplicados fuera del propio modelo en lugar de pedirle que se comporte bien.
¿Qué es una puerta de aprobación en un flujo de trabajo de un agente de IA?
Una puerta de aprobación es un punto de control que detiene a un agente antes de una acción irreversible (un pago, un borrado en producción, una rotación de credenciales, un mensaje saliente) hasta que una persona lo confirma, con la confirmación registrada para que no pueda falsificarse ni repetirse más tarde.
¿Los registros de auditoría impiden que un agente de IA realice una acción indebida?
No. Un registro de auditoría no bloquea nada por sí mismo. Es el registro duradero que hace atribuible, a posteriori, un permiso delimitado o una decisión de aprobación, y combinarlo con límites de frecuencia y alertas de anomalías es lo que convierte el registro en un control real y no en simple papeleo.
¿Por qué la autonomía excesiva es un riesgo de seguridad de IA prioritario en 2026?
El Top 10 de OWASP para aplicaciones LLM de 2026 subió la autonomía excesiva del sexto al tercer puesto porque los incidentes en producción involucran cada vez más a agentes con acceso real a herramientas y permisos reales, de modo que una salida manipulada o alucinada puede desencadenar una acción real en lugar de solo una mala respuesta.
Conclusión
Los permisos, las puertas de aprobación y los registros de auditoría son tres controles separados, no un único ajuste, y el propio criterio del modelo no es uno de ellos. Delimita las herramientas con precisión. Condiciona las irreversibles a una aprobación humana firmada. Registra cada decisión en un único punto que realmente revises. El Agent Control Standard de OWASP, donado en 2026, es el primer intento de una especificación compartida para identidad, gobernanza, pruebas y controles en tiempo de ejecución entre distintos marcos de agentes. Vale la pena seguirlo mientras madura, y vale la pena construir hacia él desde ahora.