Control de costos de agentes de IA: tokens, caché y enrutamiento de modelos, 2026
El costo de un agente de IA viene del contexto reenviado y de la salida. Guarda en caché el prefijo estable y enruta cada paso al modelo más barato que aprueba.
Introducción
El costo de un agente de IA proviene sobre todo de los tokens de entrada que se reenvían en cada turno, más los tokens de salida y de razonamiento, que cuestan más por unidad. Tres palancas lo controlan: guardar en caché la parte estable del prompt, mantener pequeño el resto del contexto y enviar cada paso al modelo más barato que aún pase tus verificaciones.
Como referencia, la documentación de gestión de costos de Anthropic reporta un promedio de unos 13 USD por desarrollador por día activo, con costos por debajo de 30 USD por día activo para el 90% de los usuarios. Tu agente será distinto, pero la mecánica es la misma. A continuación: adónde van los tokens, cómo usar la caché, cómo recortar, cómo enrutar y cómo limitar el gasto.
Adónde van los tokens de un agente
Cada turno reenvía la conversación
Un modelo no conserva memoria entre solicitudes. Por eso un bucle de agente envía el prompt del sistema, las definiciones de herramientas y toda la conversación hasta ese punto en cada turno, y cada llamada a una herramienta genera otra solicitud con el nuevo resultado. Una tarea de 20 pasos paga el contexto inicial 20 veces. La documentación de costos de Anthropic dice lo mismo sobre las sesiones largas: la conversación completa se envía con cada solicitud, así que una pregunta de una línea al final de una sesión larga paga igualmente todo el historial.
Los tokens de salida y de razonamiento cuestan más
La salida tiene un precio mayor que la entrada. En octubre de 2026, la página de precios de Anthropic lista Sonnet 5.5 a 2 USD por millón de tokens de entrada y 10 USD por millón de tokens de salida, una diferencia de 5 veces. Los tokens de razonamiento se facturan como salida, de modo que un esfuerzo de razonamiento alto en un paso simple es un costo directo, no una mejora gratuita de calidad.
Más agentes significan más solicitudes
Cada subagente envía sus propias solicitudes además de las de la conversación principal. La documentación de gestión de costos de Anthropic estima que los equipos de agentes usan aproximadamente 7 veces más tokens que una sesión estándar cuando los compañeros trabajan en modo de planificación. Agrega agentes cuando el trabajo lo exija. No por defecto.
Caché de prompts: paga una vez por el prefijo estable
Cuáles son los multiplicadores
La caché de prompts guarda el prefijo ya procesado de tu prompt para que las solicitudes siguientes lo lean con descuento. La documentación de caché de prompts de Anthropic da estos multiplicadores sobre el precio base de entrada:
- Escritura en caché de 5 minutos: 1,25x
- Escritura en caché de 1 hora: 2x
- Lectura de caché: 0,1x por defecto, y 0,05x en Opus 5.5 y Sonnet 5.5
Los puntos de corte no tienen costo propio. La guía de caché de prompts de OpenAI describe un esquema parecido para GPT-5.6 y posteriores: escrituras a 1,25x, lecturas a 0,1x y una ventana de retención de 30 minutos.
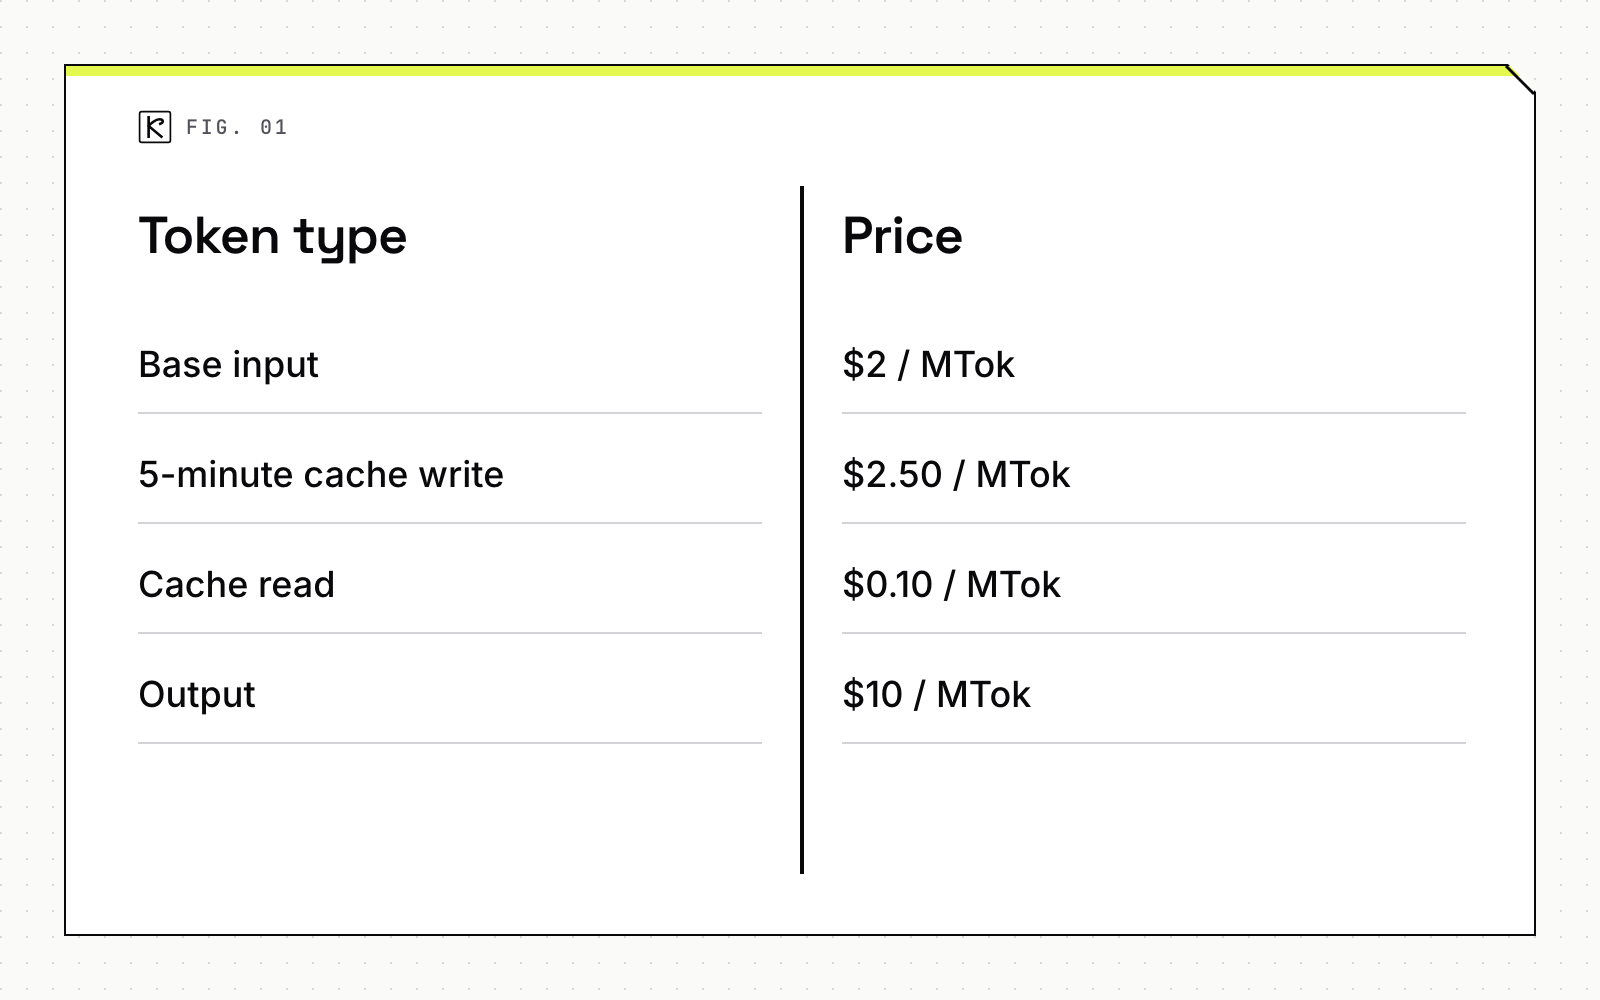
Esto significa, a precio de lista en Sonnet 5.5, en USD por millón de tokens (MTok):
| Tipo de token | Precio |
|---|---|
| Entrada base | 2 USD / MTok |
| Escritura en caché de 5 minutos | 2,50 USD / MTok |
| Lectura de caché | 0,10 USD / MTok |
| Salida | 10 USD / MTok |
Escribir en caché cuesta 25% más que la entrada normal, y cada lectura ahorra 95%. El prefijo se paga solo en la primera reutilización.
Toma un agente con un prefijo de 20.000 tokens (prompt del sistema, definiciones de herramientas, material de referencia) que ejecuta 30 turnos dentro de la ventana de caché. Sin caché, ese prefijo cuesta 600.000 tokens x 2 USD por MTok, es decir, 1,20 USD. Con caché, es una escritura de 20.000 tokens (0,05 USD) más 29 lecturas de 20.000 tokens (0,058 USD), unos 0,11 USD en total. Es aritmética a precios de lista, así que revisa la página de precios vigente antes de presupuestar, porque los precios cambian.
Estructura el prompt para obtener aciertos
Un acierto de caché exige una coincidencia exacta de todo lo que está antes del punto de corte. Anthropic guarda en caché en este orden: herramientas, luego sistema, luego mensajes, y un cambio en un nivel invalida ese nivel y todos los siguientes. Reglas prácticas:
- Pon primero el contenido estable: instrucciones, definiciones de herramientas, documentos de referencia.
- Pon al final lo que cambia en cada solicitud, como una marca de tiempo o el nombre del usuario. Una marca de tiempo dentro del prompt del sistema anula la caché en cada llamada.
- Mantén fijas las definiciones de herramientas, su orden y sus esquemas. Cambiar una definición invalida toda la caché.
- Agrega mensajes al final. No reescribas ni resumas turnos anteriores a mitad de una ejecución salvo que aceptes una reconstrucción completa; OpenAI señala que resumir o compactar puede reiniciar la reutilización.
- Coloca el punto de corte en el último bloque que permanece idéntico entre solicitudes.
Revisa la longitud mínima y verifica el acierto
Los prompts por debajo de la longitud mínima almacenable se ejecutan sin caché, y la API no devuelve ningún error. Los mínimos varían según el modelo: 512 tokens para Sonnet 5.5, Opus 5.5 y Haiku 5.5, 1.024 para Sonnet 4.6 y 4.096 para Haiku 4.5. OpenAI indica 1.024 tokens de entrada visibles para GPT-5.6 y posteriores.
No des por hecho que la caché funciona. Lee el bloque de uso en cada respuesta. En Anthropic, cache_creation_input_tokens cuenta los tokens escritos, cache_read_input_tokens cuenta los tokens leídos e input_tokens cuenta solo los tokens sin caché posteriores al último punto de corte. La entrada total es la suma de los tres. Si ambos campos de caché son 0, el prompt no se guardó en caché, normalmente por ser demasiado corto. En OpenAI, el campo equivalente es usage.input_tokens_details.cached_tokens. Registra estos valores por ejecución y activa una alerta cuando baje la proporción de lecturas.
Elige el TTL adecuado
La vigencia predeterminada de 5 minutos se renueva sin costo cada vez que se lee la caché, así que un agente ocupado la mantiene activa. Un agente que se detiene para una revisión humana perderá la ventana. Para esos casos, la opción de 1 hora cuesta 2x al escribir y resiste pausas más largas. Si una entrada de 1 hora y una de 5 minutos comparten prompt, la de 1 hora debe ir primero.
Mantén pequeño el contexto
La caché abarata los tokens repetidos, pero no los hace gratis. Un contexto inflado sigue costando lecturas, latencia y precisión. La documentación de gestión de costos de Anthropic enumera hábitos que sirven para cualquier agente que construyas:
- Limpia entre tareas no relacionadas. El contexto viejo suma tokens a cada mensaje posterior. Empieza una sesión nueva para un trabajo nuevo.
- Preprocesa antes de que el modelo vea los datos. Filtrar un registro para dejar solo las líneas de error antes de que llegue al modelo puede reducir el contexto de decenas de miles de tokens a cientos.
- Delega el trabajo ruidoso. Las ejecuciones de pruebas, la consulta de documentación y el procesamiento de registros pueden correr en un subagente cuyo contexto absorbe la salida mientras solo vuelve un resumen.
- Carga las instrucciones bajo demanda. Mantén cortas las instrucciones permanentes y mueve la guía específica de cada flujo a piezas que se cargan solo cuando hacen falta. La documentación sugiere mantener el archivo de instrucciones permanentes por debajo de 200 líneas.
- Ajusta el esfuerzo de razonamiento al paso. Baja el esfuerzo en los pasos simples, ya que los tokens de razonamiento se facturan como salida.
Vigila también el tiempo de inactividad. El primer mensaje después de una pausa más larga que la vigencia de la caché falla la caché y reprocesa todo el contexto, así que un agente programado que despierta cada 30 minutos con un TTL de 5 minutos paga el precio completo cada vez.
Enruta cada paso al modelo más barato que aprueba
Las diferencias de precio entre niveles de modelo son mucho mayores que cualquier descuento de caché. La página de precios lista, por millón de tokens y en octubre de 2026:
| Modelo | Entrada | Salida |
|---|---|---|
| Haiku 5.5 (prompts de hasta 100K tokens) | 0,10 USD | 0,50 USD |
| Sonnet 5.5 | 2 USD | 10 USD |
| Opus 5.5 | 4 USD | 20 USD |
| Fable 5.1 | 10 USD | 50 USD |
Un agente que envía todos los pasos al nivel superior paga hasta 100 veces más en entrada que uno que envía los pasos de clasificación a un modelo pequeño. Un patrón de enrutamiento habitual:
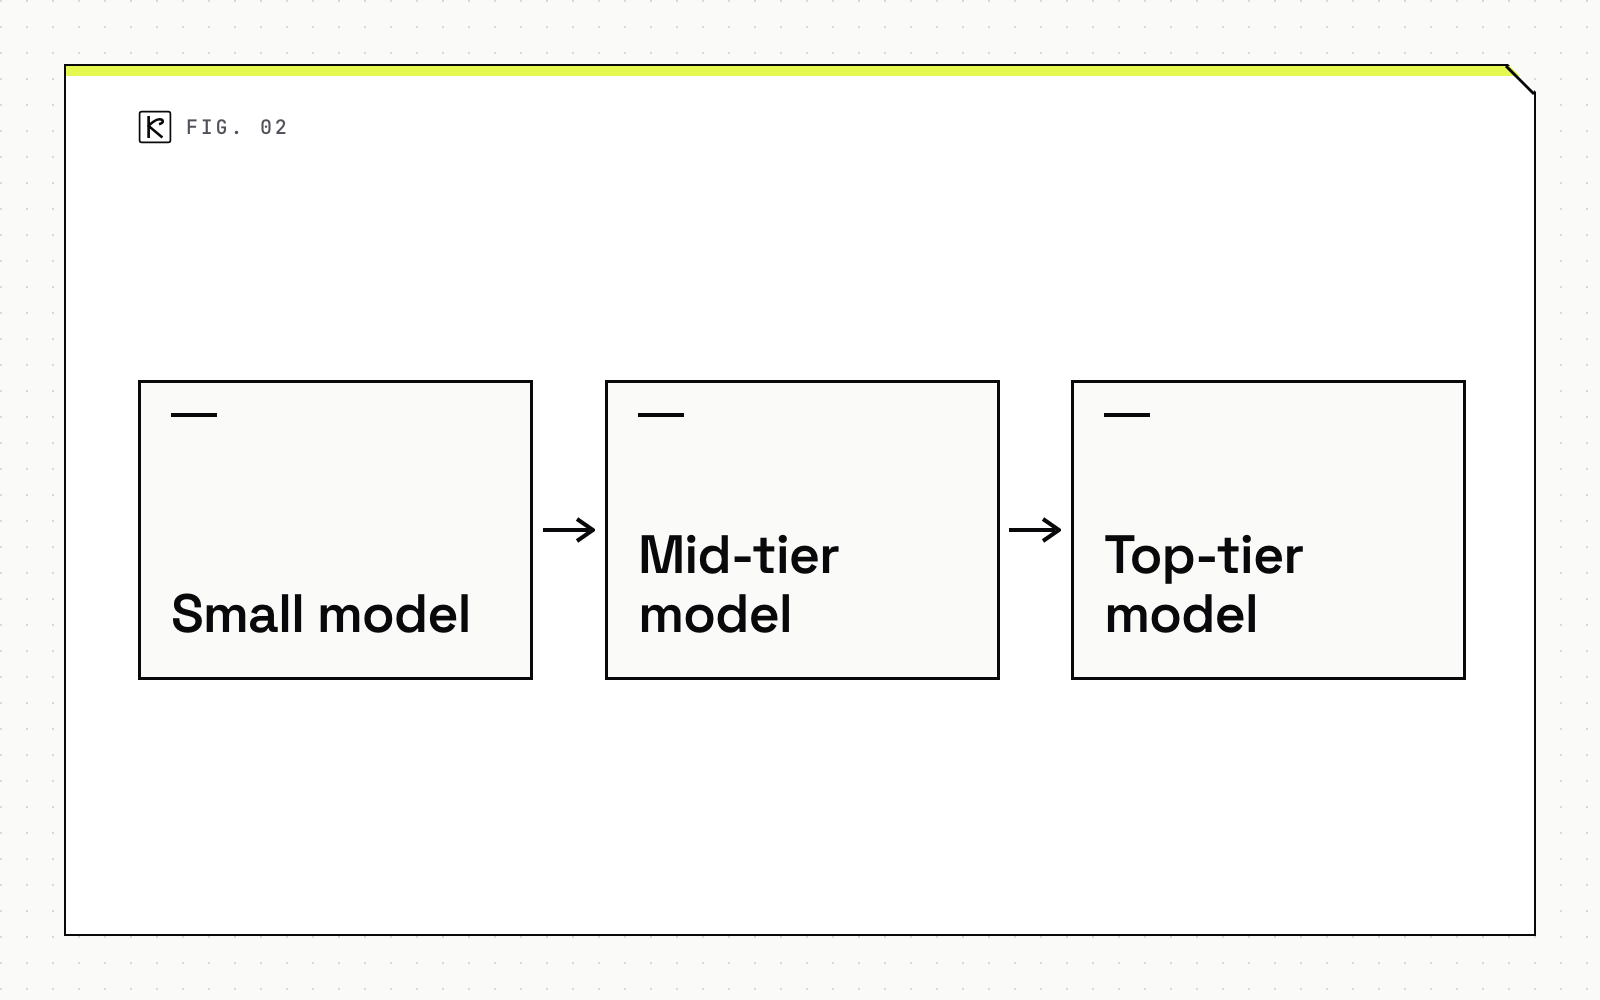
- Modelo pequeño: clasificación, extracción, formato, decisiones de enrutamiento y tareas simples de subagentes. La documentación de gestión de costos de Anthropic sugiere
model: haikupara tareas simples de subagentes. - Modelo de nivel medio: la mayor parte del trabajo con herramientas y la redacción.
- Modelo de nivel superior: planificación, solicitudes ambiguas y pasos donde un error es costoso de deshacer.
No enrutes por intuición. Construye un conjunto de evaluación con entradas reales y salidas correctas conocidas, ejecuta cada paso con el modelo más pequeño y sube de nivel solo donde la tasa de aprobación caiga por debajo de tu umbral. Nuestra guía para elegir un modelo para una función cubre con más detalle los compromisos entre calidad, latencia y costo.
Para el trabajo que nadie espera de inmediato, como resúmenes nocturnos o clasificación masiva, la API por lotes ofrece un 50% de descuento en tokens de entrada y de salida, y ese descuento se combina con la caché. A cambio, los resultados llegan de forma asíncrona en lugar de inmediata.
Fija presupuestos y condiciones de parada
La optimización reduce el promedio. Los límites te protegen del peor caso: un bucle que reintenta 200 veces una herramienta que falla. Un conjunto de controles viable:
- Un número máximo de turnos y un máximo de tokens por ejecución, impuestos en el código y no en el prompt.
- Un detector de repeticiones que detiene la ejecución cuando la misma llamada a una herramienta con los mismos argumentos aparece tres veces.
- Un límite de gasto a nivel de cuenta o de espacio de trabajo, para que un error no pueda superar una cifra mensual fija.
- Registro por ejecución de los tokens de entrada, lectura de caché, escritura de caché y salida, asociado a un identificador de ejecución, para encontrar el paso costoso.
- Un paso de aprobación humana antes de las acciones costosas o irreversibles. Consulta puertas de aprobación y registros de auditoría para ver dónde colocarlas.
Los equipos que quieran ayuda para integrar estos controles en un flujo de trabajo en producción pueden revisar el trabajo de automatización con IA de Kallos Labs.
Conclusión
Primero mide y luego optimiza en orden. Registra los campos de uso para conocer tu proporción de lecturas de caché y tu costo por ejecución. Ajusta el orden del prompt para que el prefijo se guarde en caché. Recorta el contexto que no hace falta. Enruta cada paso según los resultados de la evaluación y limita cada ejecución. Los precios y los mínimos cambian, así que revisa las páginas de precios y de caché cada trimestre.
Preguntas frecuentes
¿Cuánto ahorra la caché de prompts en un agente de IA?
En los modelos de Anthropic una lectura de caché cuesta 0,1x el precio base de entrada, o 0,05x en Opus 5.5 y Sonnet 5.5, y una escritura de 5 minutos cuesta 1,25x, por lo que un prefijo se paga solo tras una reutilización. OpenAI cobra 0,1x por lectura y 1,25x por escritura en GPT-5.6 y posteriores.
¿Cuál es la longitud mínima de un prompt para usar la caché?
Depende del modelo. Anthropic indica 512 tokens para Sonnet 5.5 y Opus 5.5, 1.024 para Sonnet 4.6 y 4.096 para Haiku 4.5, mientras que OpenAI indica 1.024 tokens de entrada visibles para GPT-5.6 y posteriores. Los prompts más cortos se ejecutan sin caché y sin ningún error.
¿Cómo sé si la caché está funcionando?
Lee el bloque de uso de cada respuesta. Si cache_creation_input_tokens y cache_read_input_tokens valen 0, el prompt no se guardó en caché; en OpenAI se revisa en cambio input_tokens_details.cached_tokens.
¿Debe un agente usar siempre el modelo más barato?
No. Enruta por paso: un modelo pequeño para clasificar y extraer, uno más potente para planificar y razonar con dificultad, y confirma cada decisión de enrutamiento con un conjunto de evaluación antes de depender de ella.