Cómo funcionan los motores de contenido con IA, y dónde va el filtro de calidad
Un motor de contenido con IA ejecuta investigación, esquema, borrador y revisión como etapas separadas. El filtro de calidad va antes de la publicación, no después.
Un motor de contenido con IA es un canal, no un único paso de generación
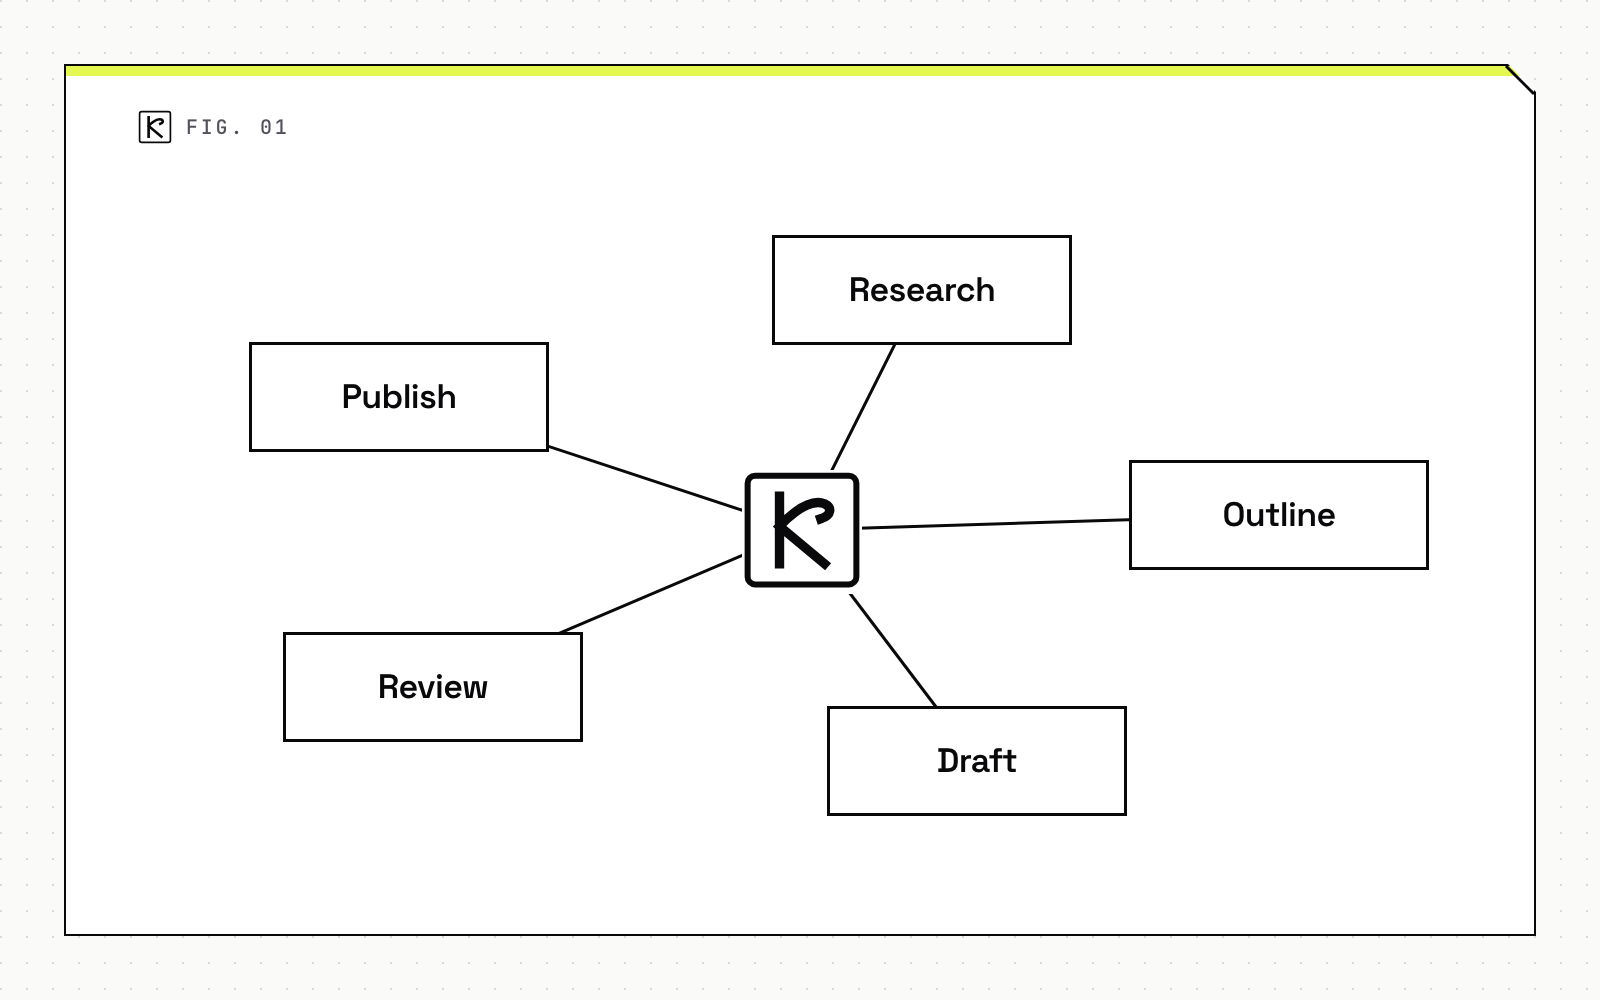
Un motor de contenido con IA es una secuencia de etapas: investigación, esquema, borrador, revisión y publicación. Cada etapa lee la salida de la etapa anterior y escribe la suya propia, como un archivo estructurado y no como un muro de prosa. Esa separación es el punto central. Un modelo puede redactar un párrafo competente en segundos, pero un párrafo no es un artículo, y un artículo no es algo que debas publicar sin revisión. El trabajo del canal es hacer que cada traspaso entre etapas sea inspeccionable, para que un borrador débil se detecte en la etapa de esquema o revisión en lugar de aparecer ya publicado.
Esto importa a cualquiera que esté evaluando si construir o comprar un sistema de contenido, no solo a los ingenieros. La pregunta que vale la pena hacerle a un proveedor no es "qué modelo usas". Es "en qué punto de tu canal se detiene un borrador malo, y qué revisa antes de dejarlo pasar".
Trata cada etapa como un contrato, no como una conversación. La investigación produce un conjunto de afirmaciones con fuente, con una URL asociada a cada una. El esquema convierte esas afirmaciones en una estructura: encabezados, una longitud objetivo y una lista de lo que todavía necesita un enlace interno o externo. El borrador rellena esa estructura, citando de vuelta a la investigación. La revisión es donde el canal deja pasar el borrador o lo devuelve. Ninguna de estas etapas necesita ser una herramienta distinta. Necesitan ser separables, para que un fallo en una no se absorba silenciosamente en la siguiente.
Por qué el volumen por sí solo es un riesgo
El instinto con cualquier sistema automatizado es usarlo para producir más. Con el contenido, ese instinto juega en tu contra. Google es explícito en que generar páginas automáticamente a escala sin supervisión ni curación manual representa poco o ningún esfuerzo, sin importar cuántas páginas salgan al otro lado, según su guía de contenido útil actualizada en octubre de 2026. Una cifra alta de páginas no mejora, por sí sola, la señal de calidad o relevancia de un sitio en las funciones de IA generativa de la búsqueda de Google tampoco.
Hay una versión más estricta de esta regla para los casi duplicados. Producir una página distinta para cada variación de cómo alguien podría buscar, incluso cuando cada página es técnicamente única, se clasifica como abuso de contenido a escala y se penaliza sin importar lo bien escrita que esté cualquier página individual. Un motor de contenido construido para enviar volumen por el volumen mismo está optimizando la variable equivocada. Un artículo bien documentado que vale la pena citar por los motores de respuesta con IA supera a diez artículos superficiales que persiguen variantes de palabras clave.
Dónde va realmente el filtro de calidad
El filtro de calidad va antes de la publicación, no después. Una revisión que se ejecuta una vez que el contenido ya está publicado e indexado solo te dice qué salió mal, después de que ya fue rastreado, posiblemente citado y posiblemente visto por un lector. Eso es una autopsia, no un filtro. La misma lógica se aplica a las puertas de aprobación y los registros de auditoría del lado del control de acceso de un sistema de IA: la revisión que importa es la que detiene la acción, no la que la registra después.
En la práctica, un canal confiable encadena tres tipos distintos de revisiones, porque cada una detecta una clase diferente de fallo. Las revisiones deterministas validan la estructura: campos obligatorios presentes, límites de caracteres respetados, frases prohibidas ausentes. Son rápidas, y no detectan nada subjetivo, que es exactamente su valor. La evaluación basada en modelos, a menudo llamada LLM como juez, escala la parte subjetiva, puntuando el tono, la claridad o el enfoque factual como lo haría un editor humano, pero tiene una limitación conocida: puede reproducir los mismos puntos ciegos y vacíos de conocimiento del modelo que está juzgando. La revisión humana sigue siendo necesaria para las partes que ninguna de las dos anteriores puede detectar de forma confiable, aunque también es el paso que no escala bien cuando un canal produce más de un puñado de artículos por semana. El patrón que funciona es ejecutar las tres y detener la ejecución en el primer fallo, en lugar de apoyarse en una sola.
Señales de autoría y actualidad
Incluso un artículo bien filtrado necesita llevar los metadatos correctos para que un lector, un motor de búsqueda o un sistema de IA confíe en él. Las señales principales son autor, titular, fecha de publicación y fecha de modificación. Estas cuatro propiedades son lo que los motores de búsqueda y los sistemas de IA leen para establecer procedencia y actualidad, y son los mismos campos que el marcado de datos estructurados está diseñado para llevar. Un canal que genera un artículo limpio pero omite los metadatos no ha terminado el trabajo.
La divulgación pertenece a esta misma categoría. La propia autoevaluación de Google para el contenido útil pregunta, directamente, si el uso de la automatización es evidente para un visitante mediante divulgación u otros medios. Eso no es una nota de cortesía. Un motor de contenido que no puede responder a esa pregunta sobre las páginas que publica tiene un vacío en su etapa de revisión, no solo en sus metadatos.
Un titular, un campo de autor, una fecha de publicación y una fecha de modificación son cuatro columnas en una fila de base de datos, nada más exótico que eso. El trabajo consiste en asegurarse de que el canal las rellene en cada ejecución, en lugar de dejar un marcador de posición que solo se nota meses después, cuando un lector o un informe de Search Console lo señala.
Cómo se ve esto para un equipo pequeño
Nada de esto requiere un equipo grande ni una plataforma a medida. Requiere decidir, antes de escribir una sola línea de código, cuáles son las etapas del canal y qué puede pasar por cada una. Es la misma disciplina que se cubre al definir el alcance de un proyecto de automatización de flujos de trabajo con IA: define las etapas, define cómo se ve un fallo en cada una, y decide quién o qué revisa la salida antes de que sea visible para cualquiera fuera del equipo.
El modelo detrás de la etapa de redacción es la parte menos interesante de esta decisión. Cambia cada pocos meses, y el canal debe construirse para que pueda hacerlo. Lo que no cambia es la forma del problema: la investigación necesita fuentes, un esquema necesita estructura, un borrador necesita revisión, y nada se publica hasta que pasa un filtro que revisa más de un tipo de cosa. Los equipos de Kallos Labs a los que se les pide construir un sistema de contenido suelen empezar ahí, porque el filtro es la parte cara de añadir después, una vez que un canal ya está publicando páginas. Si estás definiendo el alcance de uno de estos para tu propio equipo, el trabajo de automatización con IA es un punto razonable para empezar esa conversación.
Preguntas frecuentes
¿Qué es un motor de contenido con IA?
Un motor de contenido con IA es un canal de etapas discretas, típicamente investigación, esquema, borrador, revisión y publicación, donde cada etapa produce un artefacto estructurado que la siguiente etapa consume. El modelo hace el trabajo de redacción. El trabajo del canal es hacer que cada etapa sea inspeccionable y detener la ejecución antes de que un borrador débil llegue a una página publicada.
¿Publicar más páginas escritas con IA mejora la visibilidad en buscadores?
No. Una cifra alta de páginas no mejora por sí sola la señal de calidad o relevancia de un sitio, y generar páginas casi duplicadas para cada variación de búsqueda se trata como abuso de contenido a escala sin importar cómo se produjeron las páginas.
¿Dónde debe ir el filtro de calidad en un canal automatizado?
Antes de la publicación, no después. Un filtro colocado después de que el contenido ya está publicado solo detecta los problemas una vez que ya fue indexado y posiblemente citado en otros lugares. El patrón eficaz encadena revisiones deterministas de estructura y campos obligatorios, un paso de evaluación basado en modelos y una revisión humana puntual, y detiene la ejecución en el primer fallo.
¿Basta con LLM como juez por sí solo?
No. LLM como juez escala bien para criterios subjetivos como el tono, pero puede reproducir los mismos puntos ciegos y sesgos del modelo que está siendo evaluado. Pertenece junto a las revisiones deterministas y la revisión humana, no en su lugar.